案例实战 · 4 / 14
Vue/React 搜不到:robots、noindex、SSR 怎么查?
案例实战案例第 4 / 14 讲图文可选练习
这一讲会解决哪些问题
爬虫来看了一眼,和把你放进数据库是两码事
门口的保安告示,和门后的纸条
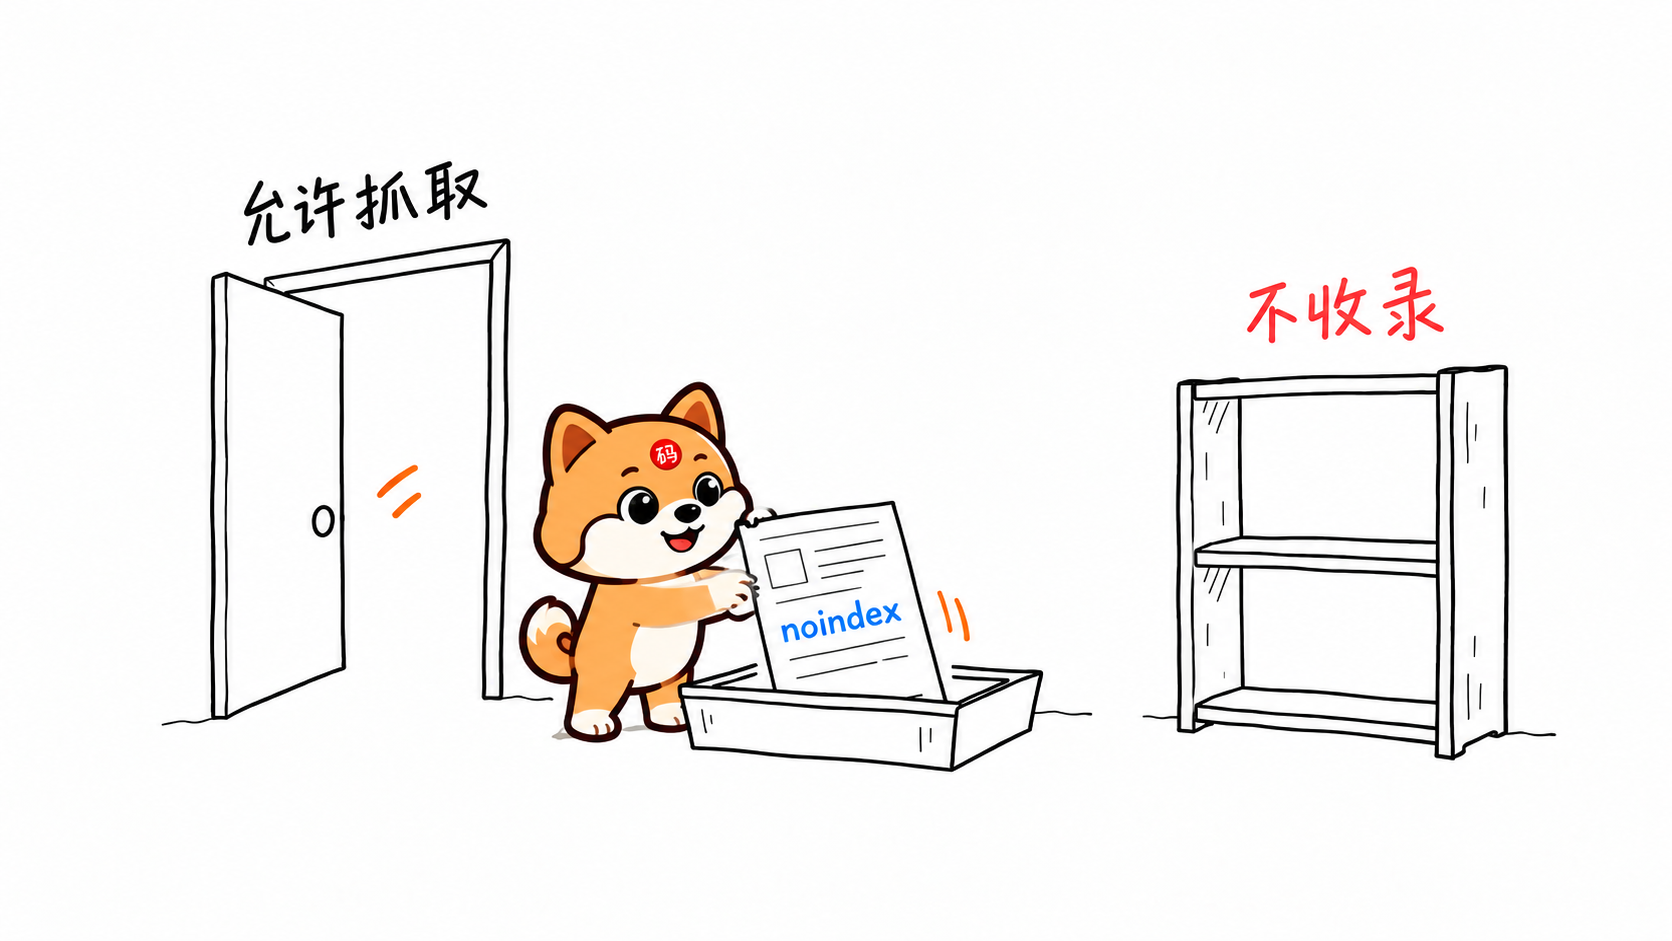
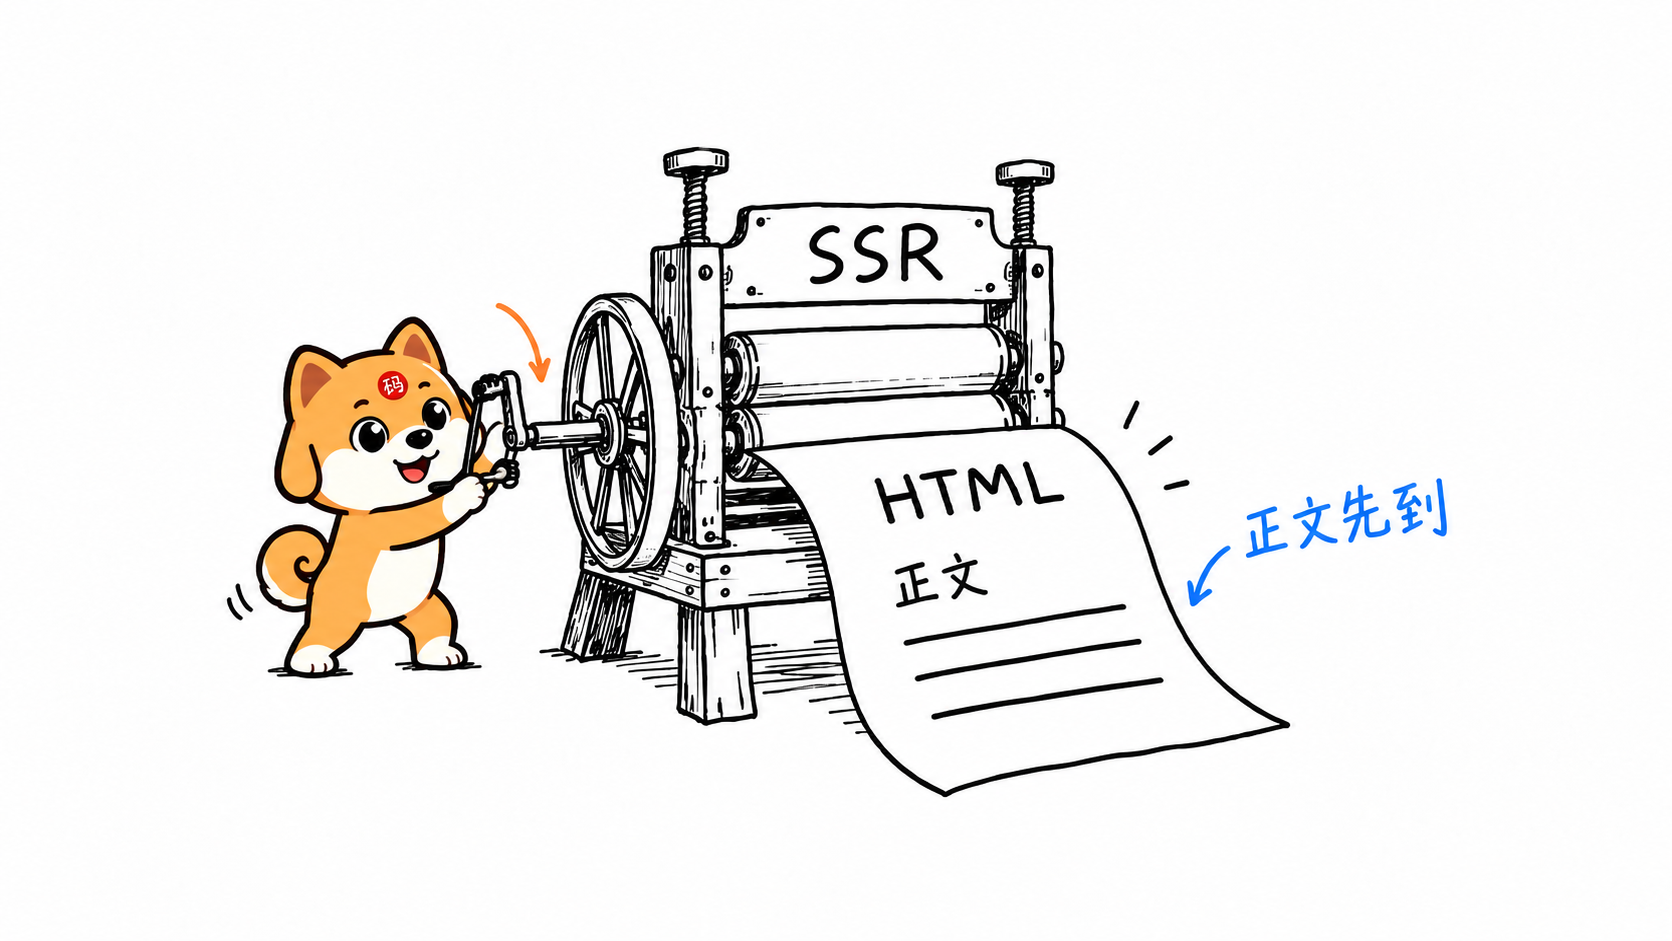
花里胡哨看够了,正文却是一张白纸
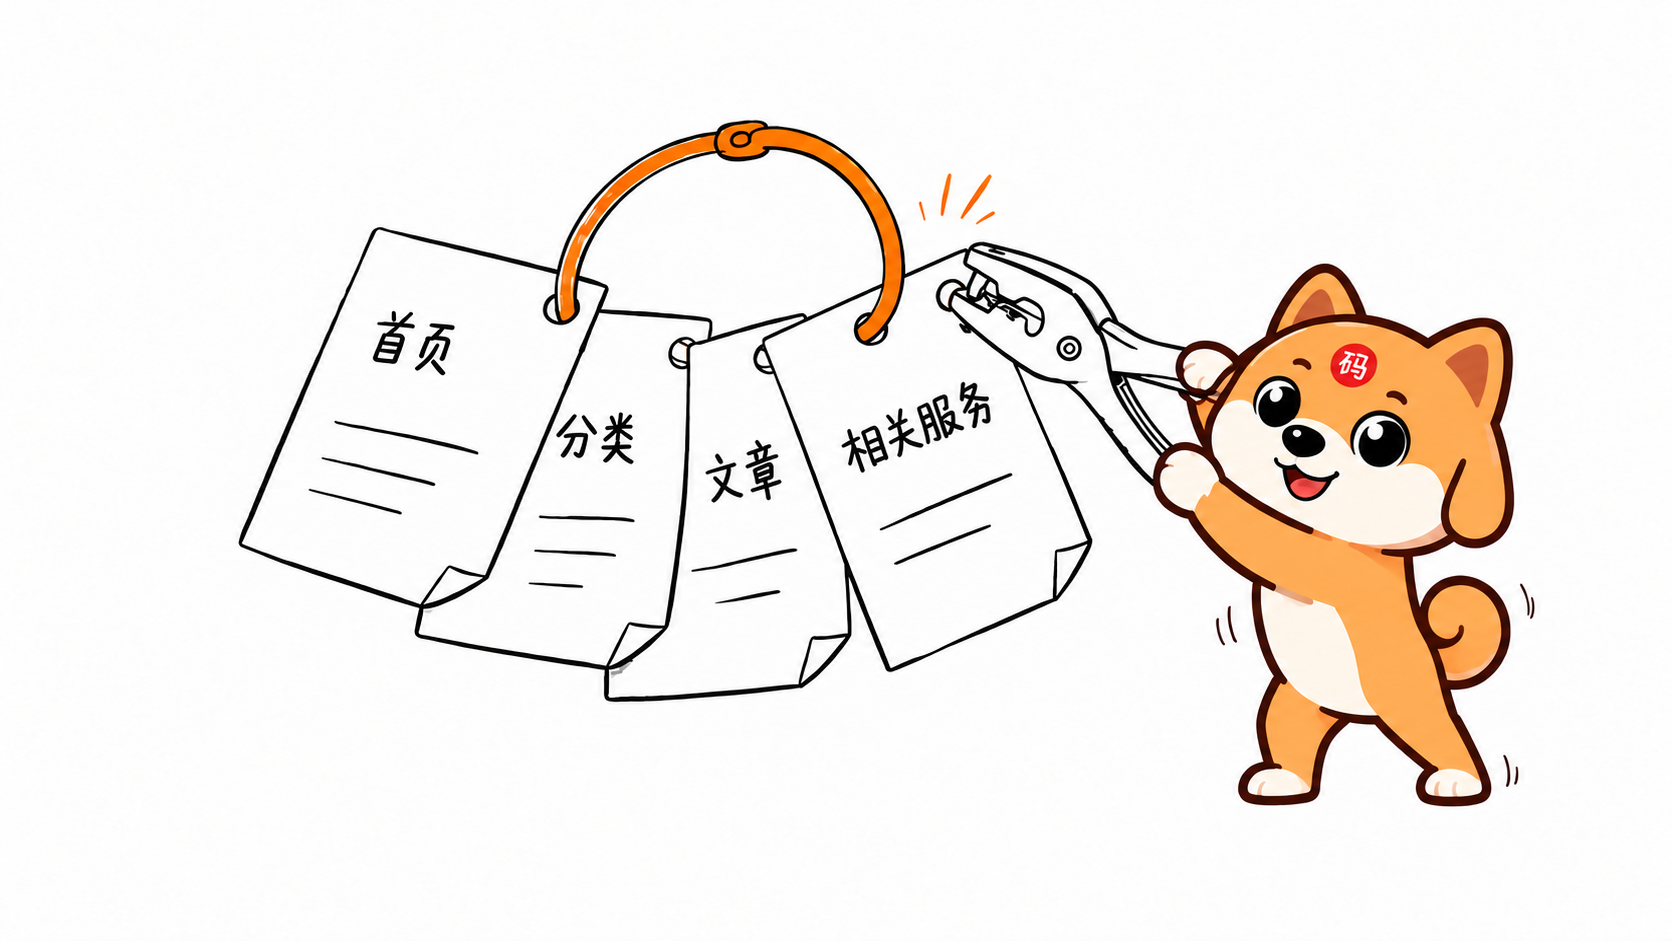
爬虫得顺着真正的链接一页一页逛
不知道收没收录,先把检查口径弄清楚
动手练习与检查工具
以下为整理时补充的练习,可按自己的业务填写;文章正文取自黄啊码原文段落。
示例 · 不同目标使用不同控制
生产公开页、公开但不参与搜索的页面、受权限保护的内部页,需要分别配置。以下仅示意 noindex 与普通链接,不能把 noindex 用作内部资料的访问保护。
<!-- 仅用于希望公开可访问、但不希望被索引的页面 -->
<meta name="robots" content="noindex">

<!-- 核心页面使用可解析链接;目标应能直接访问 -->
<a href="/guides/deploy">查看部署条件与检查步骤</a>
把这一讲用到自己的业务
- 确认公开范围先确认页面本来就适合对外公开。内部资料保持权限,必要时单独制作公开说明,不为索引盲目移除认证。
- 核对响应同时检查状态与正文,测试正常、迁移和不存在的路径。对 JavaScript 页面比较初始响应和渲染结果。
- 核对规则检查 robots、noindex、规范地址和地图是否与目标一致。记录实际读到的规则,不只看后台配置界面。
- 复查处理完成必要修改后记录版本,再通过站长工具和实际访问复查。索引与排名另行观察,不把提交按钮当完成证明。
本节交付:一份逐 URL 的技术证据表,包含访问条件、响应、渲染、抓取与索引规则,以及修改后的复查记录。
判断一下 · 页面已被 robots 禁抓,又加入 noindex,能保证搜索系统看到新规则吗?
本节判断题单选
选择后查看解释,可重新判断。
直接阅读答案说明
支持 noindex 的搜索系统需要读取标签或响应头。抓取限制、索引规则与私密内容的访问权限,应按不同目标分别配置。
动手 · 写下自己的检查记录
本节工作单填写与导出
只在当前页面整理输入,可导出到本地;不会查询外部 AI 或自动验证事实。