Token 降本增效 · 5 / 13
Qwen 的階梯逃逸:32k 紅綫
Qwen 系列的分檔邏輯和智譜完全不同:按輸入長度計費,分界綫在 32k 和 128k。最容易被忽略的計費細節是——越綫後不是「超出部分加價」,而是整個請求全量按高價檔結算。
輸入分檔全量結算RAG 成本預算感知截斷
現象:多 1k Token,整單翻倍
| 輸入長度(Qwen3-Max) | 單價(元/M,折後) | 相對基準 |
|---|---|---|
| 0 – 32k | 1.6 | 1x |
| 32k – 128k | 3.2 | 2x |
| 128k – 252k | 4.8 | 3x |
假設你的輸入是 33,000 個 Token,僅比 32k 多了 1,000。整個請求的全部 33k Token 都按 3.2 元/M 結算——不是前 32k 按 1.6 元、後 1k 按 3.2 元。多出來的這 1k,直接讓整單成本翻倍。
互動演示 · 階梯上的帳單
拖動輸入長度,注意 32k 和 128k 兩條紅綫附近發生了什麼。
28k Tokens
32k128k200k
適用單價
單次輸入成本
日均 10 萬次的月帳單
RAG 場景:在為垃圾付雙倍的錢
在 RAG 場景這個問題尤其尖鋭。假設檢索回來 5 個文檔片段,拼起來剛好 33k。這時候需要問一個問題:第 5 個片段對最終回答嘅貢獻有幾大?
如果它是核心的法律條款、關鍵的技術參數,那可能值得。但如果它只是網頁頁腳、版權聲明、重複的段落,甚至只是格式帶來的多餘換行符呢?一些粗放的 RAG 策略,正在為垃圾付雙倍的錢。
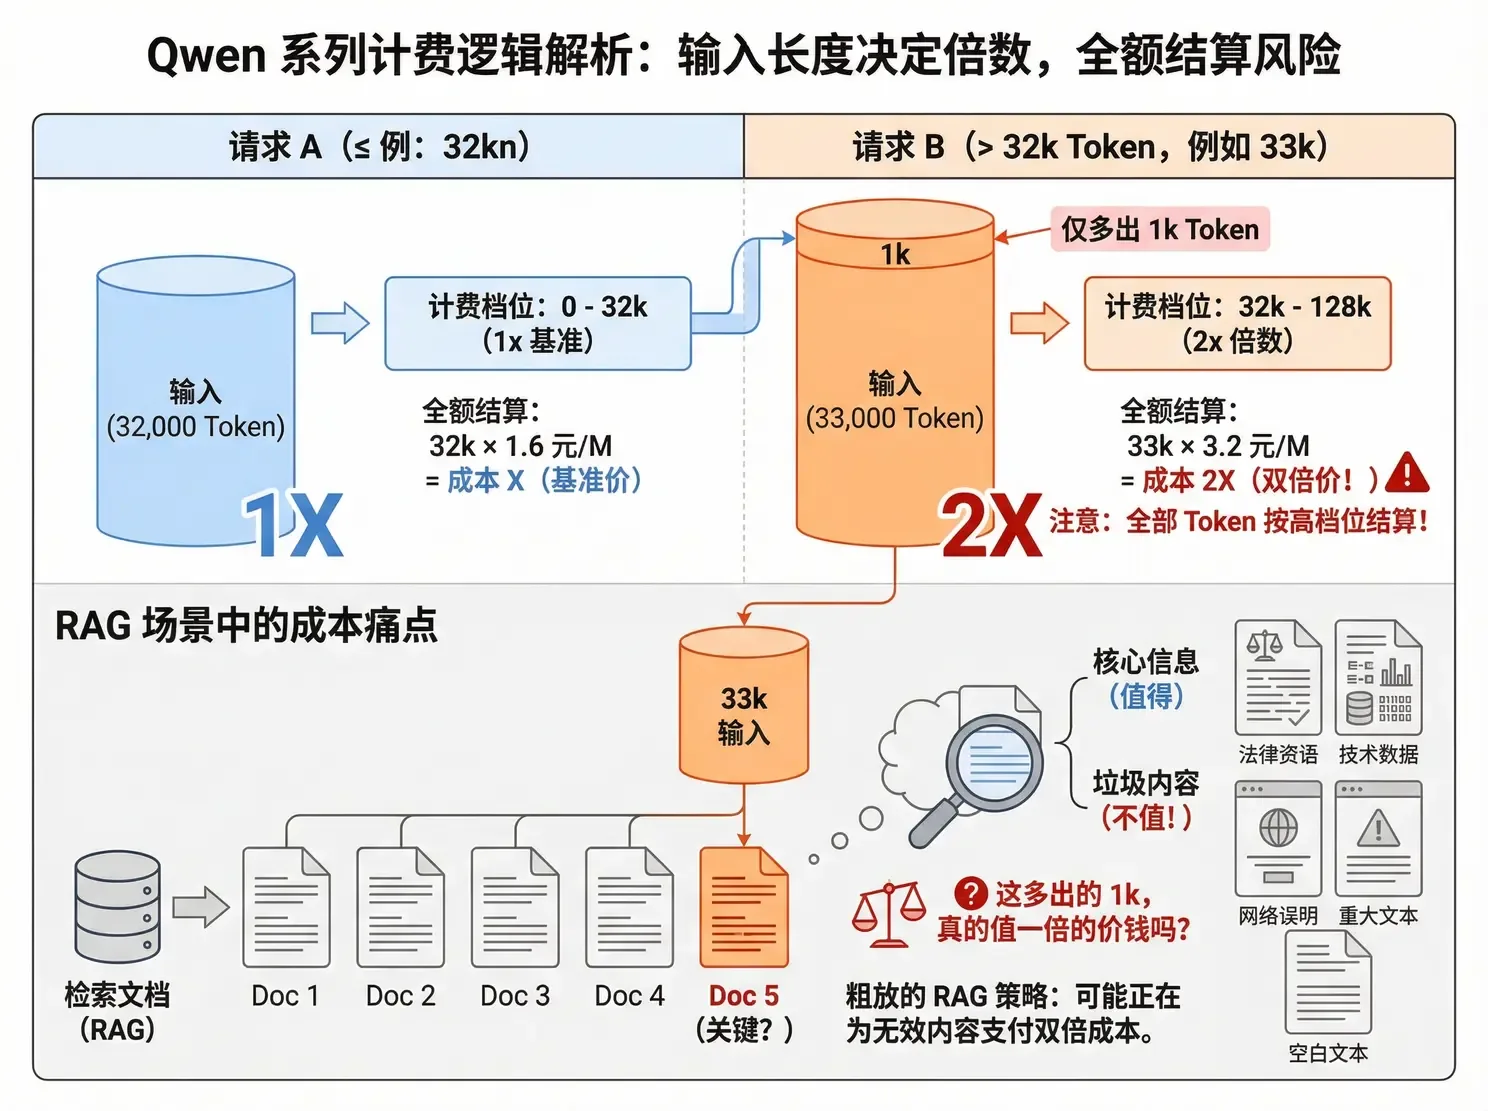
僅多出 1k Token,全部 33k 都按 2 倍價結算。RAG 檢索嘅第 5 個片段,真係值唔值一倍價錢?(圖:作者分享原稿)
策略:預算感知的動態裁剪
解法是把「32k」從一個事後才發現的帳單事故,變成一個寫進程式碼的預算約束。拼 Prompt 的邏輯不能是無腦拼接:
✗ 錯誤做法:無腦拼接prompt = system_prompt + context + user_query
✓ 正確做法:預算感知
def build_prompt_within_budget(system_prompt, context_chunks,
user_query, budget=32000):
prompt = system_prompt + user_query
current_tokens = count_tokens(prompt)
selected_chunks = []
for chunk in sort_by_relevance(context_chunks): # 按相關性排序
chunk_tokens = count_tokens(chunk)
if current_tokens + chunk_tokens > budget:
break # 到達預算上限,停止添加
selected_chunks.append(chunk)
current_tokens += chunk_tokens
return system_prompt + ''.join(selected_chunks) + user_query
| 場景 | 策略 | 説明 |
|---|---|---|
| RAG 檢索 | 動態 Top-K | 不固定取 5 個 chunk,而是取到「快到 32k」為止 |
| 多輪對話 | 歷史壓縮 | 歷史接近 30k 時觸發 Summarization |
| 長文檔處理 | 分段處理 | 不要一次性塞入,採用 Map-Reduce 模式 |
可以在業務裏畫一條紅綫:32k 是預算上限,除非有極強的業務理由,否則絕不踏入高價區。
三大定價策略對照
| 廠商 | 跳檔類型 | 關鍵閾值 | 應對策略 |
|---|---|---|---|
| 智譜 GLM-4.6 | 輸出長度跳檔 | 200 Tokens | 任務拆分,或切換到非輸出分檔模型 |
| 通義 Qwen | 輸入長度跳檔 | 32k / 128k | 預算感知截斷,動態裁剪上下文 |
| DeepSeek | 思維鏈累積 | 多輪膨脹 | 上下文清洗,用完即棄 |
本節要點
✓
Qwen 全量結算:33k 的請求,全部 33k 都按 2 倍價算。多 1k,翻一倍。
✓
問一句「第 5 個片段值不值」:粗放 RAG 正在為頁腳、免責聲明和換行符付雙倍的錢。
✓
把 32k 寫成程式碼裏的預算約束:按相關性排序、到預算即停。動態 Top-K 優於固定 Top-K。
內容來源:整理自作者團隊內部分享《AI Token 降本增效策略分享》「Qwen 的階梯逃逸」。RAG 的成本與優化策略在大模型原理 · RAG 的代價與優化策略有另一個角度的展開,可對照閲讀。