GLM의 짧은 출력 게임: 200 Token 절벽
GLM-4.6의 가격 구조를 보면 묘한 설계가 보여요. 입력 길이가 아니라 출력 길이로 구간을 나누고, 경계선은 200 Token. 출력 199와 출력 201은 완전히 다른 가격이 적용돼요.
| 지표 | Output ≤ 200 | Output > 200 | 변화 폭 |
|---|---|---|---|
| 출력 단가 | 4 위안/M | 7 위안/M | +75% |
| 입력 단가 | 1 위안/M | 1.5 위안/M | +50% |
가장 놓치기 쉬운 점: 출력만 200 Token을 넘으면, 이미 보낸 수천 개 입력 Token도 더 높은 가격으로 다시 정산돼요. 출력에 글자 두 개만 더 써도, 전체 요청이 소급 인상돼요.
이건 추론 연산력의 한계 비용 곡선을 반영해요. 짧은 출력(<200 Token)은 매우 가벼워요. Decode 부담이 작고, KV Cache 점유가 제한적이라 수십 밀리초면 끝날 수도 있어요. 출력이 길어지면 Token을 하나 더 생성할 때마다 KV Cache가 VRAM을 더 먹고, Attention도 한 바퀴 더 돌아요—비용이 비선형으로 커져요.
시나리오: 사용자 리뷰에서 구조화 JSON을 추출(sentiment / aspects / pain_points / suggestions). Prompt는 이미 깔끔한데, 각 리뷰에서 얼마나 뽑힐지는 미리 알 수 없어요—단순 리뷰는 150 Token, 불만이 두 점만 더 있어도 230. 슬라이더를 끌어 “구조적 충돌”을 느껴 보세요.
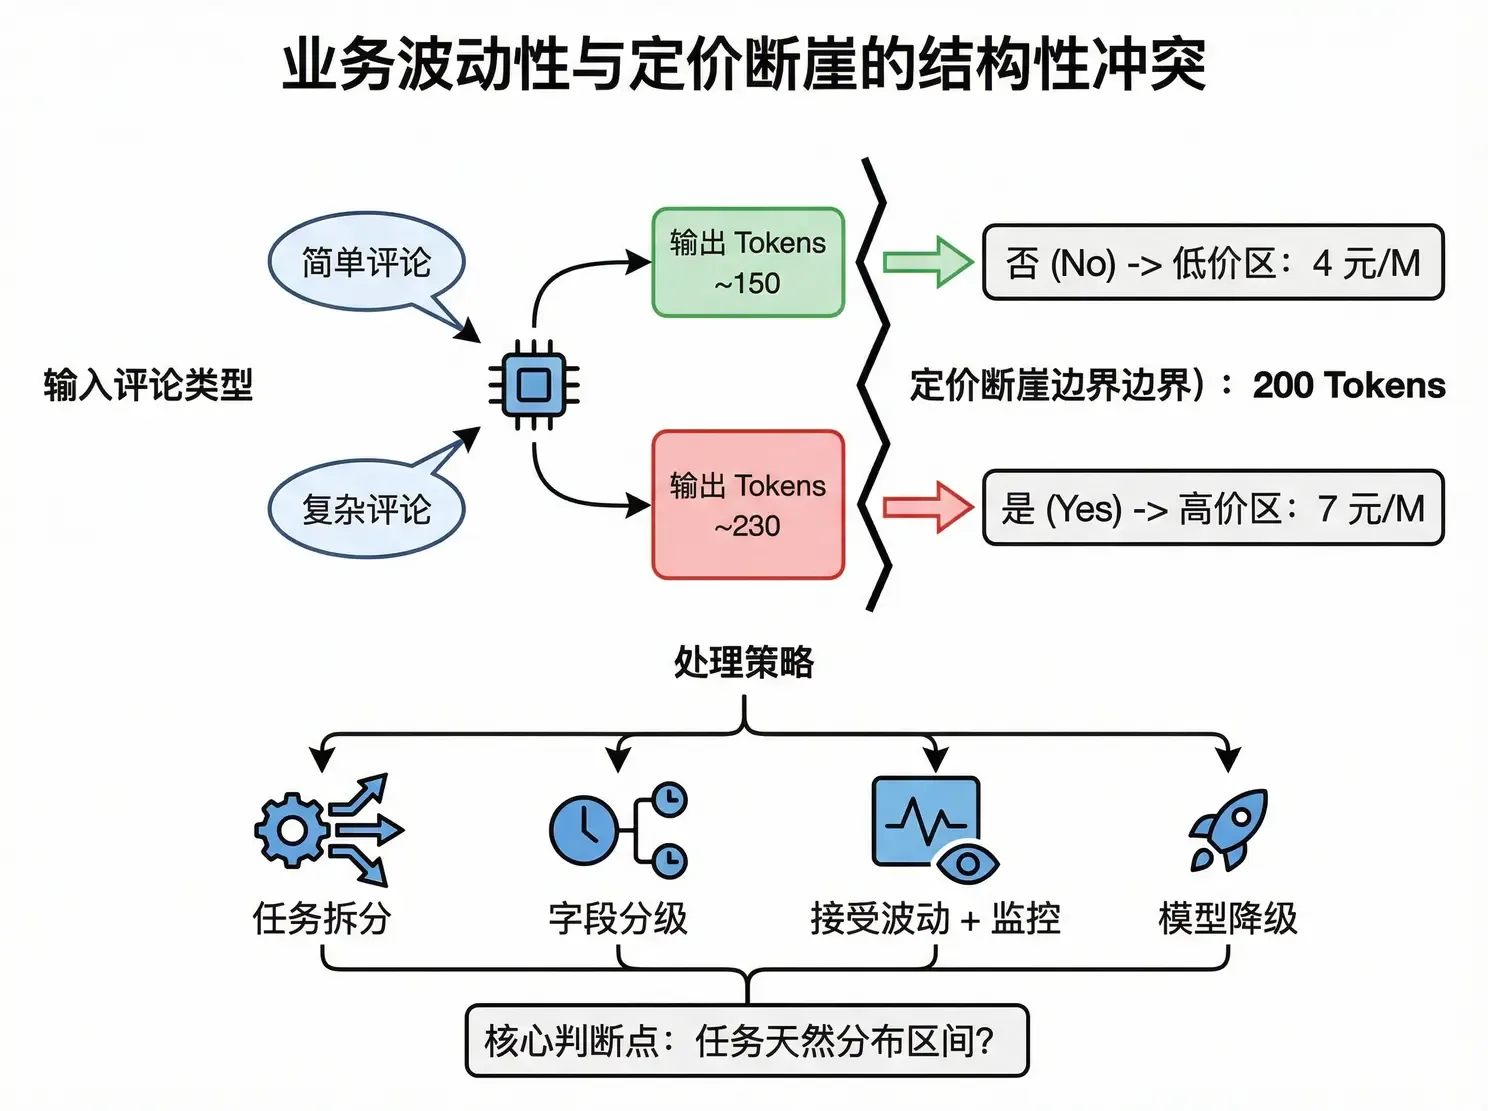
| 전략 | 방법 | 대가 |
|---|---|---|
| 작업 분할 | 추출을 여러 번 호출로 나누고, 매번 필드 1–2개만 뽑아요 | 호출 수 증가, 지연 상승 |
| 필드 등급화 | 핵심 필드는 실시간 추출, 부차 필드는 비동기 보완이나 후처리 | 아키텍처 복잡도 증가 |
| 변동 수용 + 모니터링 | 가끔 구간 점프는 허용하되, 전체 분포를 모니터링해요 | 비용은 통제 가능하지만 최선은 아님 |
| 모델 다운그레이드 | 가격에 민감한 대량 작업은 Qwen-Flash 같은 대량 모델로 전환 | 정확도를 조금 희생할 수 있음 |
핵심 판단 포인트는: 이 작업의 출력은 원래 어느 구간에 떨어지나요? 대부분 요청이 100–150이고 가끔만 200을 넘으면 감수할 수 있어요. 분포의 중앙값이 이미 180–220이면, 작업이 원래 절벽 위에 앉은 거예요—작업 단위를 다시 짜거나, 출력으로 구간을 나누지 않는 모델로 바꿔야 해요. 비슷한 상황은 코드 생성에도 나와요: 20줄짜리 함수만으로도 100+ Token을 쉽게 쓰고, 조금만 복잡한 수정 제안이면 200을 넘어요.
GLM-4.6은 출력 길이로 구간을 나누고, 200이 절벽이에요: 출력 +75%, 입력 소급 +50%.
가격 구조는 연산 비용을 반영해요: 긴 출력의 KV Cache와 Attention 비용이 비선형으로 커지고, 벤더는 가격으로 짧고 빠른 길로 밀어 넣어요.
먼저 작업의 출력 분포를 보고, 그다음 전략을 고르세요. 중앙값이 절벽 위에 있는 작업은 단위를 다시 자르거나, 과금 방식이 다른 모델로 바꾸세요.
출처: 저자 팀 내부 공유 《AI Token 비용 엔지니어링 전략 공유》 「GLM-4.6의 짧은 출력 게임」에서 정리했어요. 가격은 당시 저자 할인 단가이며, Zhipu 오픈 플랫폼의 실시간 요금을 기준으로 하세요.