語義層:雙重蒸餾
格式的稅砍完了,往深一層看內容本身。RAG 和長文件場景裡最常見的工程錯誤:把上下文視窗當垃圾桶——Few-Shot 案例、檢索文件全塞進去,讓模型自己辨識。能用,但不該這樣用。
第一,貴而且慢。Transformer 自注意力的計算複雜度是 O(N²):提示詞長度翻倍,計算量翻四倍。提示詞越長,Prefill 越久,首字延遲越高——使用者還沒看到第一個字,耐心已經消磨沒了。
第二,效果可能更差。有效資訊被廢話淹沒後,會產生「中段迷失」效應。就像人讀長文章:開頭認真看(要搞清楚講什麼),結尾也留意(快出結論了),中間那一大坨——眼睛掃過去,腦子沒過去。你精心挑選的參考資料如果不幸落在中段,模型可能根本沒認真看。
色條模擬模型對 Prompt 各位置的注意力強度(綠=強,灰=弱)。拖動長度,看中段怎麼塌下去。
拿 Text-to-SQL 舉例:為了覆蓋各種業務場景,有人在 Prompt 裡寫死 20 個 SQL 案例,加起來 4,000 多 Token。每次使用者提問,模型都要先「複習」一遍這 4,000 字,既燒 Token 又慢。換個思路:
把 20 個案例存進向量資料庫。
使用者問「上個月銷售額」時,先用語義檢索只撈 Top-3 個財務相關的案例。
最終 Prompt 從 4,000 Token 砍到 500。
(去掉了無關案例的干擾)
金融研報、會議紀要這類文件充滿「正確的廢話」:免責聲明、重複的背景介紹、口語化墊話。直接餵給 AI,等於花大成本請博士生幫你讀垃圾郵件。
解法是在 RAG 檢索後、送去推理之前,插一層 LLMLingua-2 中介軟體。它不是粗暴砍詞:用 BERT 的雙向注意力同時看到上下文前後,精準識別核心語義(實體、資料、關鍵動詞),剔掉冗餘噪音。壓縮 5–20 倍,原本 1 秒的預填充壓完 50 毫秒搞定——高併發場景吞吐量直接上一個量級。
| 蒸餾 | 物件 | 手段 | 典型收益 |
|---|---|---|---|
| 第一重 | Few-Shot 案例 | 向量檢索動態選 Top-K | 4,000 → 500 Token |
| 第二重 | 檢索回來的文件 | LLMLingua-2 語義壓縮 | 壓縮 5–20 倍,預填充 1s → 50ms |
提示詞翻倍 = 計算量翻四倍:O(N²) 是長上下文又貴又慢的物理根源。
中段迷失:關鍵資訊放開頭或結尾,中間留給丟了不心疼的內容。
Few-Shot 別硬編碼,存向量庫按問題動態檢索:省 87.5% 還更準。
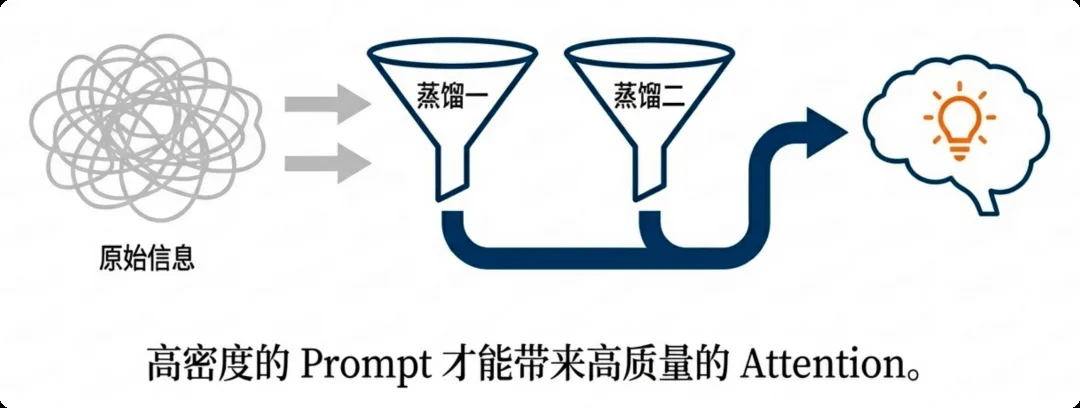
長文件先過 LLMLingua-2 再推理:高密度 Prompt 換高品質 Attention,別讓使用者在等待裡流失。
內容來源:整理自作者團隊內部分享《AI Token 降本增效策略分享》實戰篇「02|語義層」。中段迷失可延伸閱讀 Chroma 的上下文腐爛(Context Rot)研究;壓縮基準見 LLMLingua。上下文視窗原理複習Harness 核心 · 上下文視窗。