PART 5 · Harness 與自我改進
進化搜索:讓最強 Harness 存活
進化算法 + 編碼 Agent = 在龐大的 Harness 設計空間中自動發現最優解。
為什麼進化搜索適合 Harness 優化?
講人話:進化搜索就係大自然選育莊稼嗰套:種一大片,長得好就留種,長得差就淘汰,間中雜交變異一下,一代代落嚟莊稼越來越好。點解用呢招?因為 Harness 係由 prompt、程式碼、配置混搭出嚟嘅嘢,冇辦法用數學公式計出最優解(術語叫梯度不可用),但好易比出邊個好邊個差。可以打分、唔可以求解嘅問題,就啱「養一羣、留最強」。
三個契合條件
1. 搜索空間龐大且形狀奇特:Harness 的組件包括自然語言 prompt、程式碼邏輯、工具配置,組合爆炸且高度離散。
2. 梯度不可用,但評估容易:無法對 prompt 文本求導,但可以直接在基準測試上跑出分數。
3. 多樣性有價值:不同任務可能需要不同風格的 Harness,進化天然維護種羣多樣性。
2. 梯度不可用,但評估容易:無法對 prompt 文本求導,但可以直接在基準測試上跑出分數。
3. 多樣性有價值:不同任務可能需要不同風格的 Harness,進化天然維護種羣多樣性。
Prompt 進化的先驅
Promptbreeder & GEPA
Promptbreeder(Fernando et al. 2023):用豐富的變異操作進化 task-specific prompts。關鍵創新:變異 prompt 本身也通過進化改進,形成元進化。
GEPA(Agrawal et al. 2025):結合 reflection-based prompting 和進化搜索。Agent 先反思當前 prompt 的不足,再通過進化算子產生候選改進,最終選擇最優。
這兩項工作為後續更大規模的 Harness 進化奠定了基礎。
GEPA(Agrawal et al. 2025):結合 reflection-based prompting 和進化搜索。Agent 先反思當前 prompt 的不足,再通過進化算子產生候選改進,最終選擇最優。
這兩項工作為後續更大規模的 Harness 進化奠定了基礎。
AlphaEvolve:編碼 Agent 的進化搜索
講人話:AlphaEvolve 就係將上面「選育莊稼」用喺程式碼度:養住一個程式碼農場(候選程式池),等 AI 每輪同表現好嘅程式碼提修改意見(生成 diffs),改完跑分,分高就留低繼續繁衍。Google 真係用佢發現到比人類已知更快嘅矩陣乘法算法:莊稼揀出咗新品種。
AlphaEvolve(Novikov et al. 2025)
核心思路:維護一個候選程式池,用凍結的 LLM 生成程式碼 diffs 來改進程式,反覆評估子程式並保留表現最好的。
Novikov et al. "AlphaEvolve: A coding agent for scientific and algorithmic discovery." 2025.
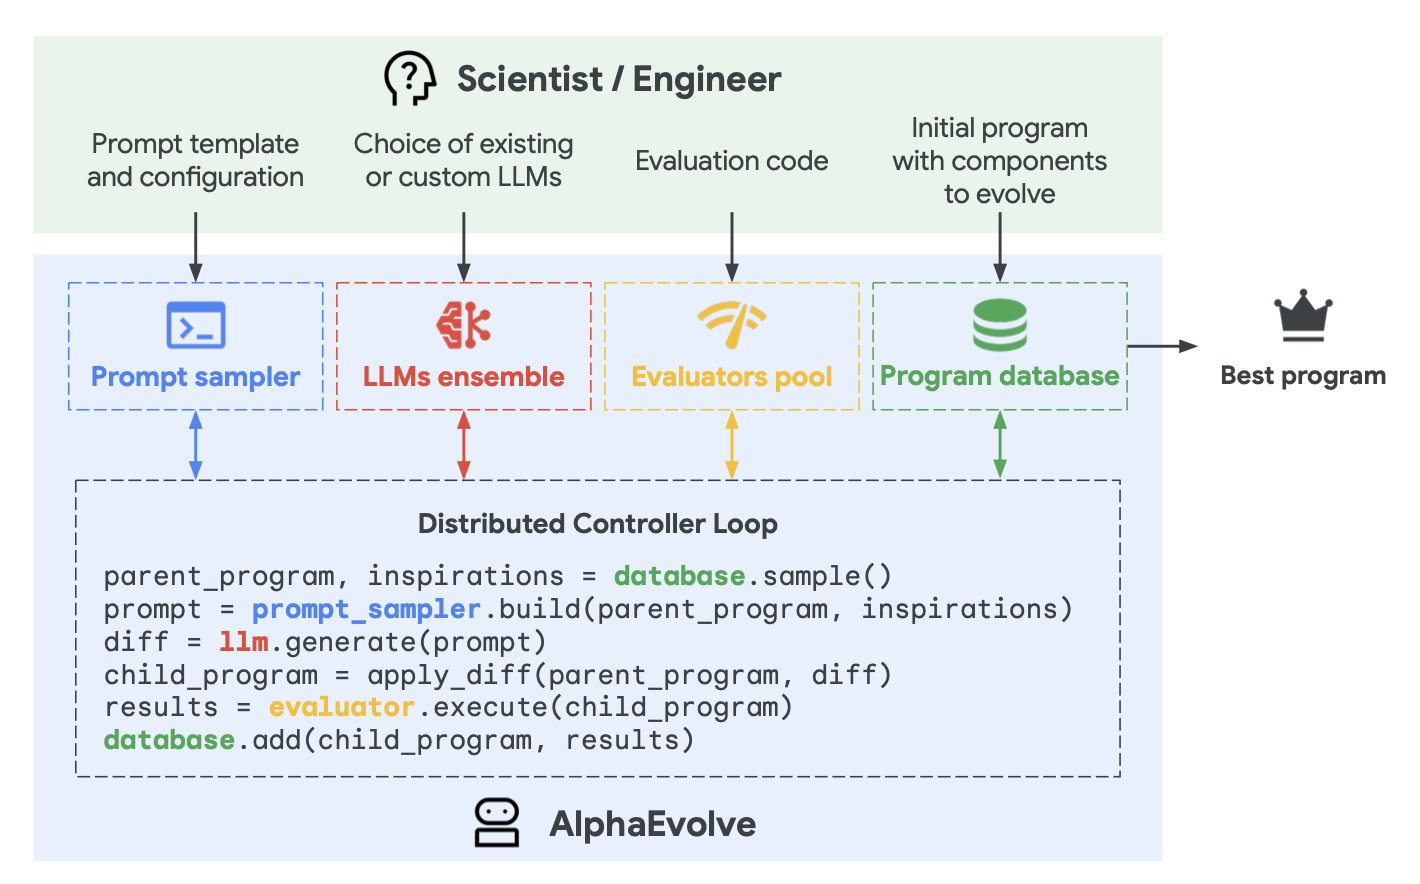
AlphaEvolve 系統架構:候選程式池 → LLM 生成 diffs → 評估 → 適者保留。
Prompt 設計
父程式 + 評估結果 + 指令 + 元信息共同構成進化 prompt
進化標記
用 # EVOLVE-BLOCK-START / # EVOLVE-BLOCK-END 顯式標記可改進區域
Meta-prompt
指令和上下文本身也參與共同進化,不會固定不變
消融實驗
證明進化流程、上下文 prompt、meta-prompt、全文件進化、更強 LLM 各自有獨立貢獻
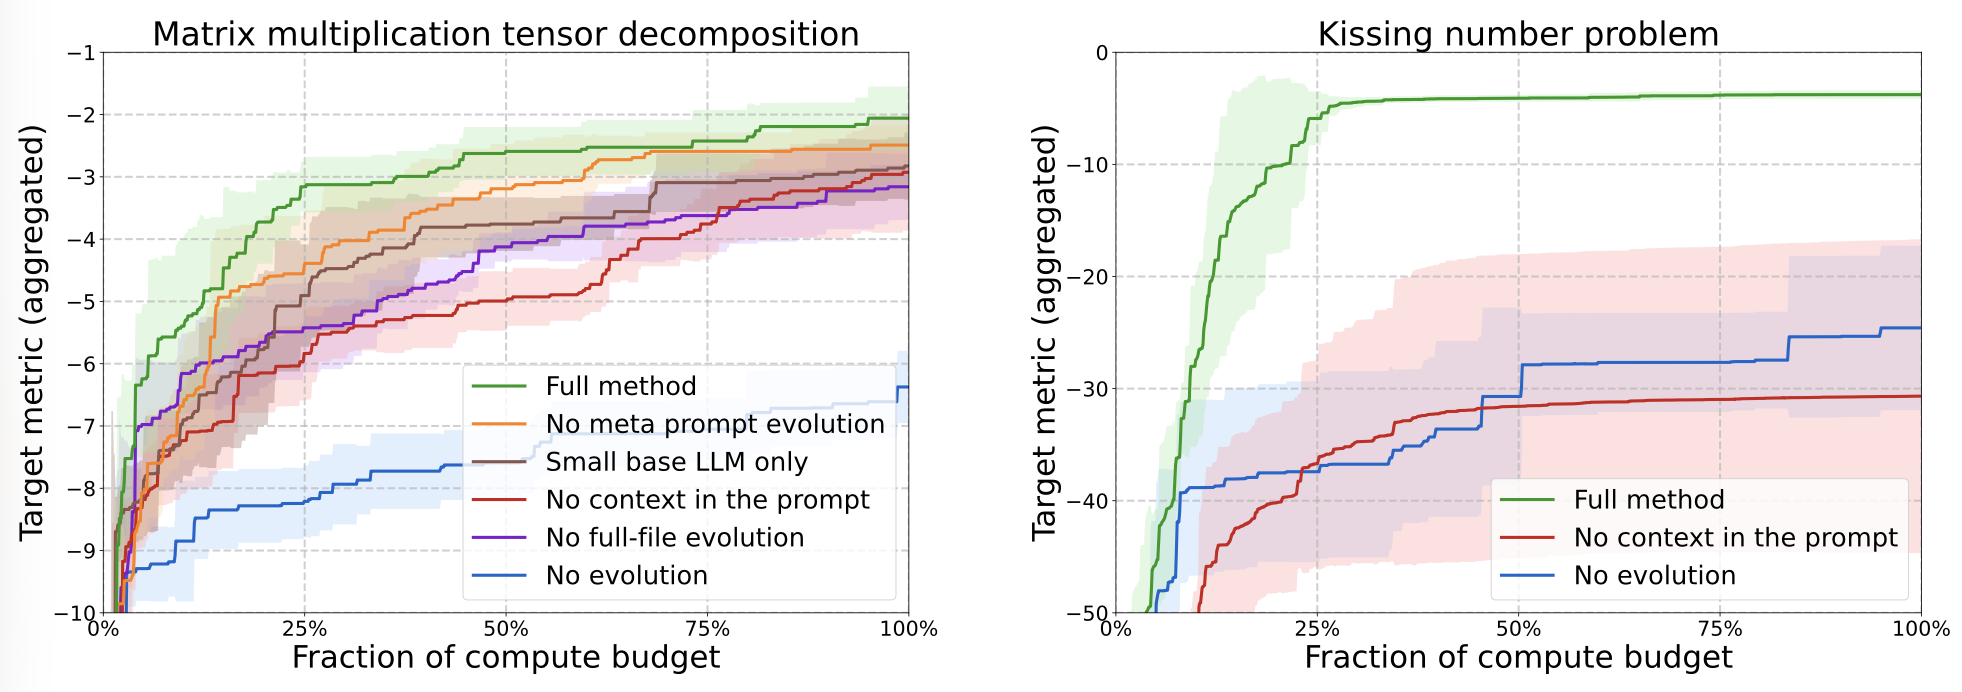
AlphaEvolve 消融實驗:各組件對最終性能的貢獻。
Darwin Gödel Machine(DGM)
講人話:DGM 比 AlphaEvolve 更激進:進化對象係 Agent 自己嘅「操作系統」(佢自己份 harness 程式碼),已經超出改人哋程式碼嘅範疇。等於一羣機械人,每個都可以睇自己考試錯題、然後動手改造自己大腦回路,改得好嘅就留低繼續繁衍後代。名入面個「達爾文」就係呢個意思:物競天擇,最強嘅自我改造方案先至留得低。
DGM(Zhang et al. 2025)
與 AlphaEvolve 不同,DGM 顯式針對可編輯的 harness 程式碼倉庫進行進化:Agent 被允許修改自己的 harness 程式碼。
Zhang et al. "The Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents." 2025.
- 初始化:從池中一個 coding agent 開始
- 選擇父代:按性能概率選一個父代(概率與子代數量成反比,鼓勵探索)
- 反思 + 提議:父 agent 檢查自己的 benchmark 評估日誌,提出 harness 改進方案
- 變異:修改 harness 程式碼,產生新 agent
- 評估:新 agent 在基準測試上評估,只有性能足夠高才被加回池中
- 重複:循環直到達到停止條件
DGM 工具與實驗結果
工具集:bash + editor(view / create / edit)
實驗(基於 Claude 3.5 Sonnet):
· SWE-bench Verified:20% → 50%(+30 pp)
· Polyglot:14.2% → 30.7%(+16.5 pp)
無需人類介入,Agent 自主進化出更強的 harness 設計。
實驗(基於 Claude 3.5 Sonnet):
· SWE-bench Verified:20% → 50%(+30 pp)
· Polyglot:14.2% → 30.7%(+16.5 pp)
無需人類介入,Agent 自主進化出更強的 harness 設計。
適用範圍與侷限
適用場景
- 候選解可自動評估
- Fitness 易量化(數值化指標)
- 矩陣乘法加速
- GPU kernel 優化
- 算法競賽
- 數據中心調度
不適用場景
- 評估速度慢(每次需數小時)
- 評估標準模糊或主觀
- 主要基於啓發式判斷
- 計算預算有限
- 需要人類審核環節
效率關注點
進化搜索的計算開銷不可忽視。AlphaEvolve 和 DGM 都需要大量評估輪次,每輪都涉及 LLM 推理 + 程式碼執行 + 基準測試。計算效率(每代需要多少次評估)和進化效果(每代提升多少)之間的平衡仍是開放問題。
聯合優化:模型權重 + Harness
講人話:前面所有方法都淨係改工作流程,唔郁 AI 個大腦(模型權重)。SIA 想兩個一齊改:又優化流程,又順便重新訓練大腦。聽落好靚,但風險都大:就好似一邊改賽車引擎一邊改賽道,兩邊同時變就容易失控(呢個就係文中講嘅訓練穩定性問題)。
SIA(Hebbar et al. 2026)
SIA 將 harness 改進和模型參數更新放入同一優化循環:
· Meta-Agent:提出新的 harness 設計
· Task-Specific Agent:在新 harness 下執行任務
· Feedback-Agent:根據結果決定下一步是更新 harness 還是更新模型權重
方向有趣,但證據暫時性:訓練穩定性和 Goodhart 效應(優化代理指標導致真實目標退化)仍是開放挑戰。
· Meta-Agent:提出新的 harness 設計
· Task-Specific Agent:在新 harness 下執行任務
· Feedback-Agent:根據結果決定下一步是更新 harness 還是更新模型權重
方向有趣,但證據暫時性:訓練穩定性和 Goodhart 效應(優化代理指標導致真實目標退化)仍是開放挑戰。
Hebbar et al. "Self-Improving Agents." 2026.
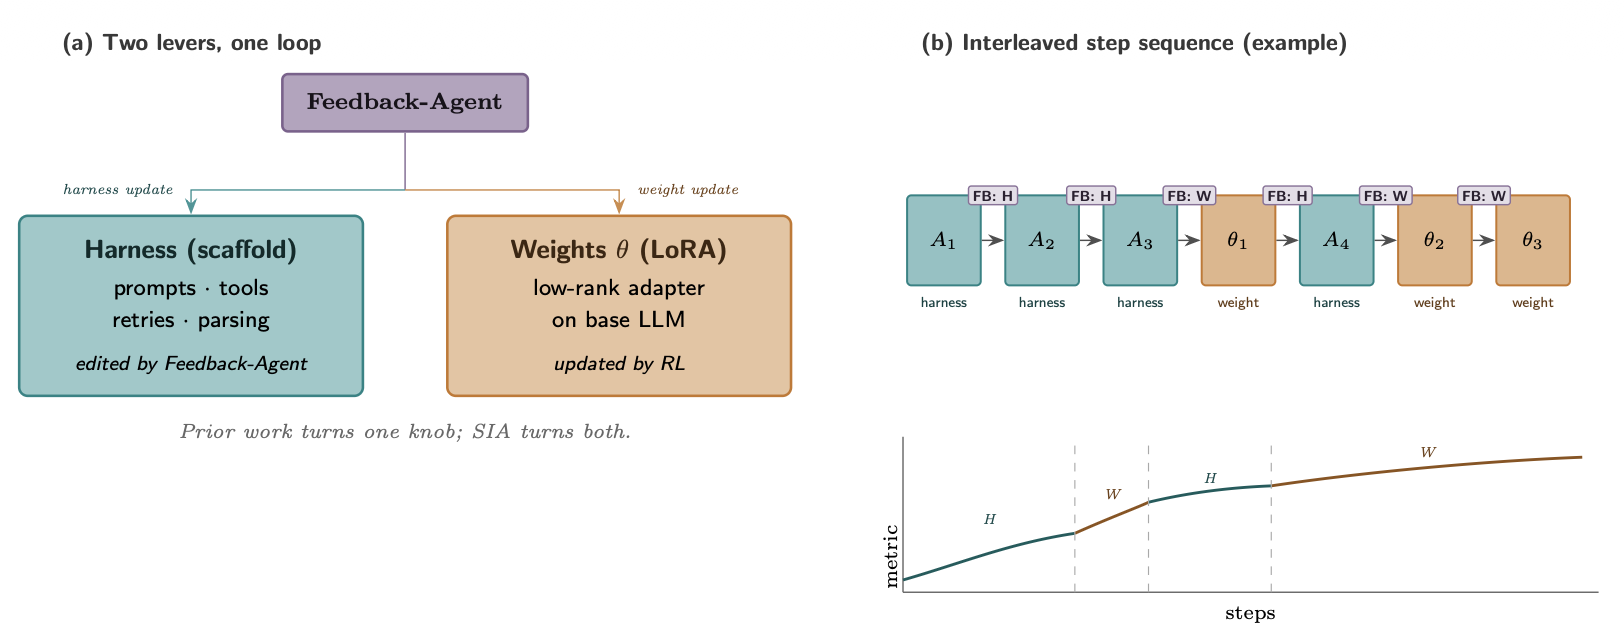
SIA 架構:Meta-Agent 提出 harness → Task Agent 執行 → Feedback Agent 決定優化方向。
核心觀點:當搜索空間龐大、梯度不可用、但評估容易時,進化搜索是優化 Harness 的自然選擇。從 Promptbreeder 的 prompt 進化,到 AlphaEvolve 的程式進化,再到 DGM 的 harness 程式碼自我改寫,進化壓力正在讓最強的 Agent 存活。未來的 SIA 方向則試圖讓 harness 和模型權重協同進化,但穩定性挑戰仍待解決。