PART 5 · Harness 與自我改進
讓 Harness 改進自己
如果 LLM 能優化執行 Agent 的程式碼,它就能接觸比手寫 Prompt 大得多的設計空間。
STOP: Self-Taught Optimizer
講人話:想像一個識磨刀嘅工匠。平時做法係用刀切菜(用工具解決問題);STOP 嘅做法係先將磨刀手藝練好,刀自然越來越利。更妙嘅係,磨刀手藝本身都可以再磨:用改進嘅方法去改進「改進方法」本身,一層套一層,越滾越強。
核心思想:不改善解,改善「改善器」
STOP(Zelikman et al. 2023)是遞歸腳手架改進的早期範例。它不直接改善一個解 s。它不斷改善的是產生更好解的「改善器」I 本身。
種子改善器 I₀ 接受三個輸入:初始解 s、效用函式 u、黑盒語言模型 M,返回改善後的解 s'。
關鍵洞察:改善器本身也是文本(一段 prompt 或程式碼),因此可以把同樣的改善邏輯作用在改善器自身上。
種子改善器 I₀ 接受三個輸入:初始解 s、效用函式 u、黑盒語言模型 M,返回改善後的解 s'。
關鍵洞察:改善器本身也是文本(一段 prompt 或程式碼),因此可以把同樣的改善邏輯作用在改善器自身上。
// STOP 遞歸更新公式
I_t = I_{t-1}(û, I_{t-1}; M)
// 其中:
// I_{t-1} — 當前改善器(文本形式的 prompt/程式碼)
// û — meta-utility:衡量改善器質素的函式
// M — 黑盒語言模型
// 輸出 I_t — 更好的改善器
I_t = I_{t-1}(û, I_{t-1}; M)
// 其中:
// I_{t-1} — 當前改善器(文本形式的 prompt/程式碼)
// û — meta-utility:衡量改善器質素的函式
// M — 黑盒語言模型
// 輸出 I_t — 更好的改善器
呢條公式講緊咩:唔好畀符號嚇親,其實得一句:用今日嘅自己去升級尋日嘅自己。I 就係嗰個升級方法,公式講嘅係:用舊版升級方法,對住自己操作一次,產出新版升級方法。好似你用 3.0 版學習方法總結出 4.0 版學習方法。
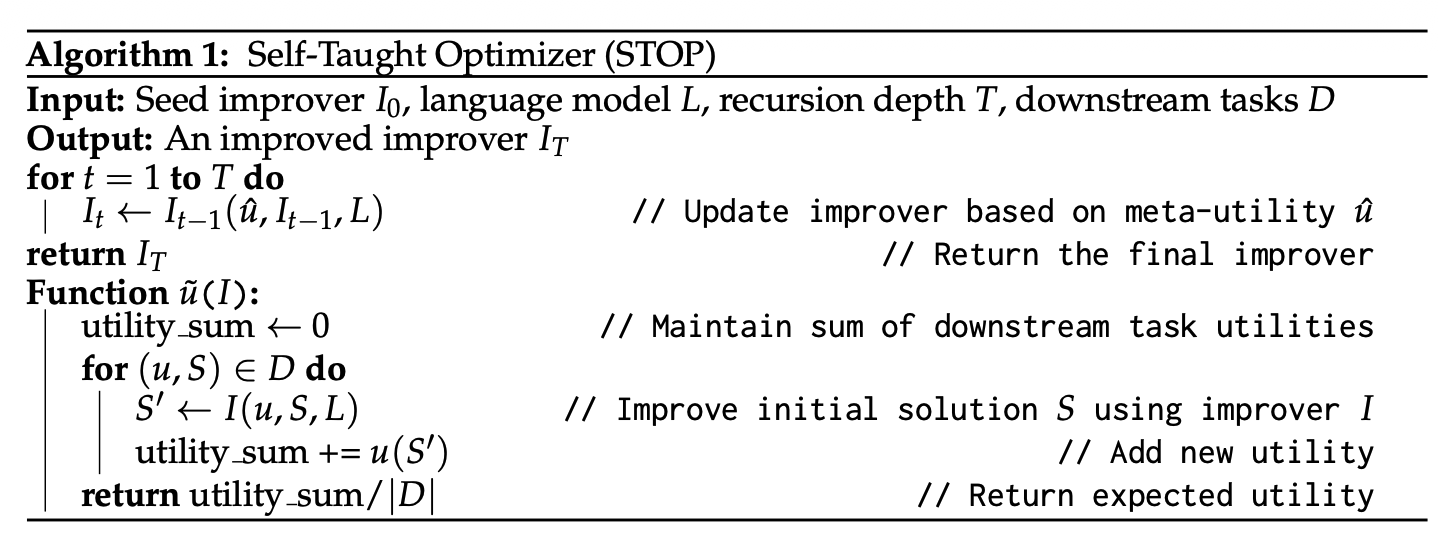
STOP 算法流程:改善器遞歸地作用於自身,產生越來越好的改善策略。(Zelikman et al. 2023)
STOP 的發現
自動發現的策略
改善後的改善器自動發現了遺傳算法、分解改進、多臂 Prompt Bandit、模擬退火、Beam Search 等經典優化策略,無需人類預設。
基座模型門檻
GPT-4 能持續改善,但 GPT-3.5 和 Mixtral 反而退化。遞歸結構本身不夠:基座模型必須足夠強,才能支撐元級優化。
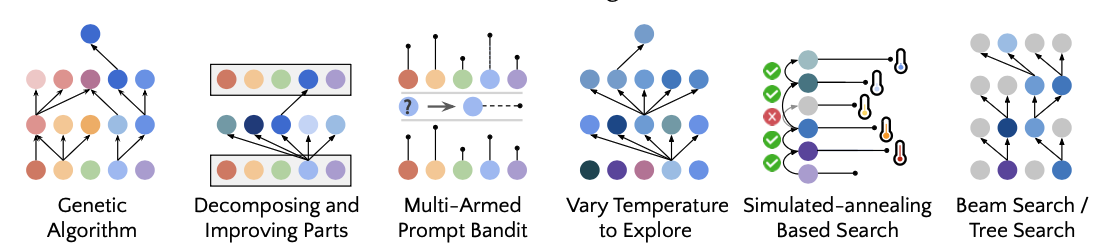
STOP 在不同模型上的表現:只有足夠強的基座模型才能通過遞歸改善持續進步。(Zelikman et al. 2023)
警示:遞歸 ≠ 必然改善
遞歸結構給出了改善的可能性,但不保證收斂。弱模型在元級操作中缺乏足夠的編程直覺,反而會放大噪聲:結果不進反退。這提示我們:自我改進系統的安全性必須建立在對基座能力的準確評估之上。
Self-Harness:Agent 改進自己的 Harness
講人話:呢個就好似員工自己同自己做績效覆盤:① 翻出所有搞砸嘅案例,搵返反覆踩過嘅坑(Weakness Mining 搵弱點);② 針對性改自己份工作手冊(Harness Proposal 提修改方案);③ 用新手冊試跑一段時間,確認舊本事冇退步、新毛病冇出現,先正式採用(Validation 驗證)。成個過程都唔使老闆插手。
Propose → Evaluate → Accept 循環
Self-Harness(Zhang et al. 2026)讓 LLM Agent 通過三階段循環改進自己的 Harness 配置。不同於 STOP 的純文本改善器,Self-Harness 直接操作 Agent 的運行時編排系統,包括 system prompt、工具調度策略、驗證規則等。
1
Weakness Mining
聚類失敗軌跡為 verifier-grounded 失敗模式。每條失敗記錄需包含:終端驗證器級原因 + 相關 Agent 行為的因果狀態 + 軌跡暴露的抽象 Agent 機制。
→
2
Harness Proposal
基於挖掘的失敗模式提出有界 Harness 編輯。模型獲得:可編輯面、失敗模式摘要、通過行為記錄、已嘗試編輯的歷史。優先選擇可尋址的重複錯誤模式。
→
3
Proposal Validation
用 held-in 和 held-out 數據集驗證候選編輯。只接受沒有迴歸的編輯,確保改進不以犧牲已有能力為代價。
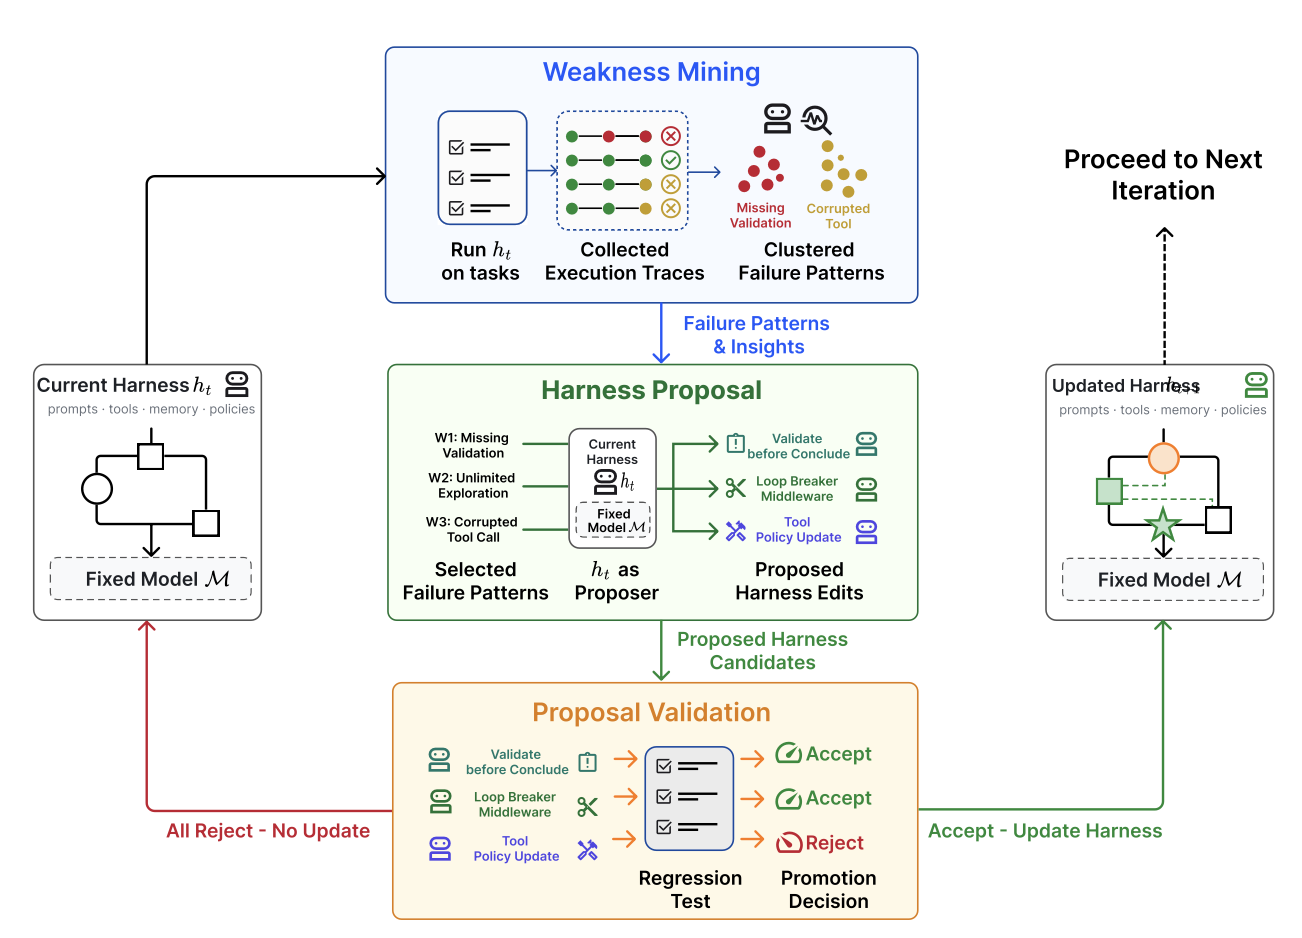
Self-Harness 的三階段循環:從失敗中學習,提出有界編輯,驗證後接受。(Zhang et al. 2026)
實驗驗證
在 Terminal-Bench-2 上對 MiniMax M2.5、Qwen3.5-35B-A3B、GLM-5 進行實驗。Self-Harness 為每個模型學習到了模型特定的 harness 指令:同一個框架對不同基座產生了不同的優化路徑,説明 Harness 改進確實是上下文敏感的。
關鍵洞察
Harness 設計 = 可執行的搜索空間
一旦 Harness 的設計被形式化為可執行的搜索空間(可編輯的 prompt、策略配置、工具編排程式碼),強編碼 Agent 就能利用人類工程師使用的同一設計空間:自動化地搜索、提案、驗證,不再需要依賴人工逐個調試。這打開了遠比手寫 prompt 更大的改進可能性。
安全邊界不可或缺
如果程式被允許編輯 OS 系統層面的配置,抽象邊界就會被打破。自我改進系統的可編輯面需要合理設計:權限控制和安全層必須在改進循環之外,由人類或不可篡改的監管機制保障。沒有邊界的自我改進是失控的自我改進。