PART 5 · Harness 與自我改進
Harness 的三大設計模式
好的 Harness 有清晰的模式語言,絕非一堆腳本拼起來。三個核心模式,覆蓋了當前最強 Agent 系統 90% 的架構決策。
Pattern 1
1
Workflow Automation
工作流自動化
核心思想:Agent 是一個目標導向的迴圈,不能當成執行一次就結束的腳本。
- Plan → Execute → Observe/Test → Improve → Execute again:每一輪生成都是下一輪優化的起點。
- 分析自身軌跡:優秀的 Agent 會回頭看自己前幾輪做了什麼、哪裡失敗了、為什麼失敗,然後調整策略,避免重複同一個 Prompt。
- 強調執行時迭代:改進發生在 Agent 執行過程中,不依賴人類事先寫好的靜態模板。Agent 在每次執行中學習、適應、優化。
- 失敗是訊號,不是終止:測試不通過、命令報錯、輸出不符合預期,這些都是 Agent 自我糾正的觸發條件。
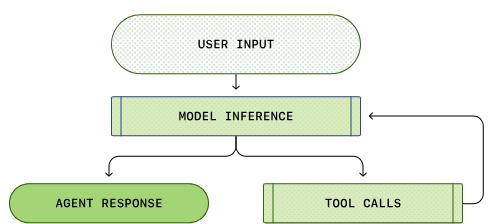
Agent 工作流迴圈:plan → execute → observe → improve → execute again(來源:OpenAI Codex Agent Loop)
設計啟示
不要把 Agent 設計成一次性回答器。讓它擁有自己審查自己的能力:看到測試失敗後自動分析原因、看到 linter 報錯後自動修復、看到使用者回饋後調整策略。這就是工作流自動化的核心:把回饋迴圈內建到系統裡。
Pattern 2
2
File System as Persistent Memory
檔案系統做持久記憶
核心問題:在長期執行的 Agent 中,製品會迅速超出上下文視窗。
- 製品種類繁多:實驗日誌、程式碼 diff、論文摘要、錯誤追蹤記錄、過去的完整執行軌跡,這些都是有價值的狀態,但塞不進上下文。
- Harness 的正確做法:把持久狀態存在檔案系統中,讓 Agent 學會按需讀寫。不要試圖把全部工作歷史壓入 Prompt。
- 檔案讀寫是 LLM 基礎技能:讀寫檔案系統不需要複雜的外部工具鏈,它受益於核心模型能力的提升。模型越聰明,檔案管理越高效。
- 結構化儲存:好的 Agent 會自己維護 scratchpad、todo 列表、實驗記錄,像人類程式設計師一樣管理工作區。
上下文 vs 檔案:何時放哪裡?
放上下文中:當前正在處理的任務指令、即時的工具呼叫結果、最近 2-3 輪對話,這些是需要即時參考的資訊。
放檔案系統中:歷史實驗結果、累積的錯誤日誌、已完成子任務的摘要、長期策略和規則,這些是需要持久儲存但不必時刻在視野中的資訊。
關鍵原則:上下文是工作記憶,檔案系統是長期記憶。好的 Harness 像人腦一樣,在兩者之間智慧地搬運資訊。
放檔案系統中:歷史實驗結果、累積的錯誤日誌、已完成子任務的摘要、長期策略和規則,這些是需要持久儲存但不必時刻在視野中的資訊。
關鍵原則:上下文是工作記憶,檔案系統是長期記憶。好的 Harness 像人腦一樣,在兩者之間智慧地搬運資訊。
Pattern 3
3
Sub-agent and Backend Jobs
子 Agent 與後臺任務
核心思想:一個 Agent 不夠用時,生成多個子 Agent 並行執行,同時監控後臺長任務。
- 父 Agent 作為行程管理器:啟動子任務、檢查日誌和進度、取消失敗的分支、合併成功的結果。這是作業系統層面的思維。
- 並行性必須顯式且可檢查:不能「發射後不管」。父 Agent 需要能查看每個子 Agent 的狀態、輸出和錯誤。
- 子 Agent 輸出持久化:每個子 Agent 的結果存為檔案、日誌或狀態記錄(而不僅是返回到父 Agent 的上下文中),這樣即使中斷也能恢復。
- 容錯與恢復:後臺任務可能超時、崩潰或產出低品質結果。Harness 需要設計重試策略和優雅降級機制。
關鍵設計決策
子 Agent 模式的核心取捨:並行帶來速度,但也帶來複雜性。成功的實現(如 Cursor 的 Task 系統、Claude Code 的子行程)都遵循同一原則:讓每個子 Agent 在獨立的沙箱中工作,輸出到明確的檔案路徑,父 Agent 透過輪詢檔案狀態來協調,不做記憶體共享。這極大簡化了併發控制。
Case Study · 編碼 Agent 的 Harness
主流編碼 Agent 的核心工具介面
Claude Code、Codex、OpenCode、Cursor,這些當前最強的編碼 Agent 都圍繞相似的工具集構建 Harness。下表按功能分組對比它們的核心介面:
| 工具分組 | 核心能力 | 典型工具 |
|---|---|---|
| File System | 讀、寫、搜尋、編輯檔案;管理工作區狀態 | Read, Write, Edit, Glob, Grep, StrReplace |
| Shell Execution | 執行終端命令、執行測試、安裝依賴 | Shell, BashExec, RunCommand |
| I/O | 與使用者互動、確認操作、展示結果 | Ask, UserConfirm, ShowResult |
| External Context | 取得外部資訊、文件、API 響應 | WebFetch, ReadURL, DocSearch |
| Web Search | 上網搜尋取得最新資訊 | WebSearch, BingSearch |
| Artifacts | 生成、管理和版本化製品 | CreateFile, SaveArtifact, VersionControl |
| Backend Processes | 後臺執行長任務、監控行程狀態 | BackgroundShell, AwaitProcess, Monitor |
| Agent Delegation | 生成子 Agent、分配並行任務、合併結果 | Task, Subagent, Fork, ParallelRun |
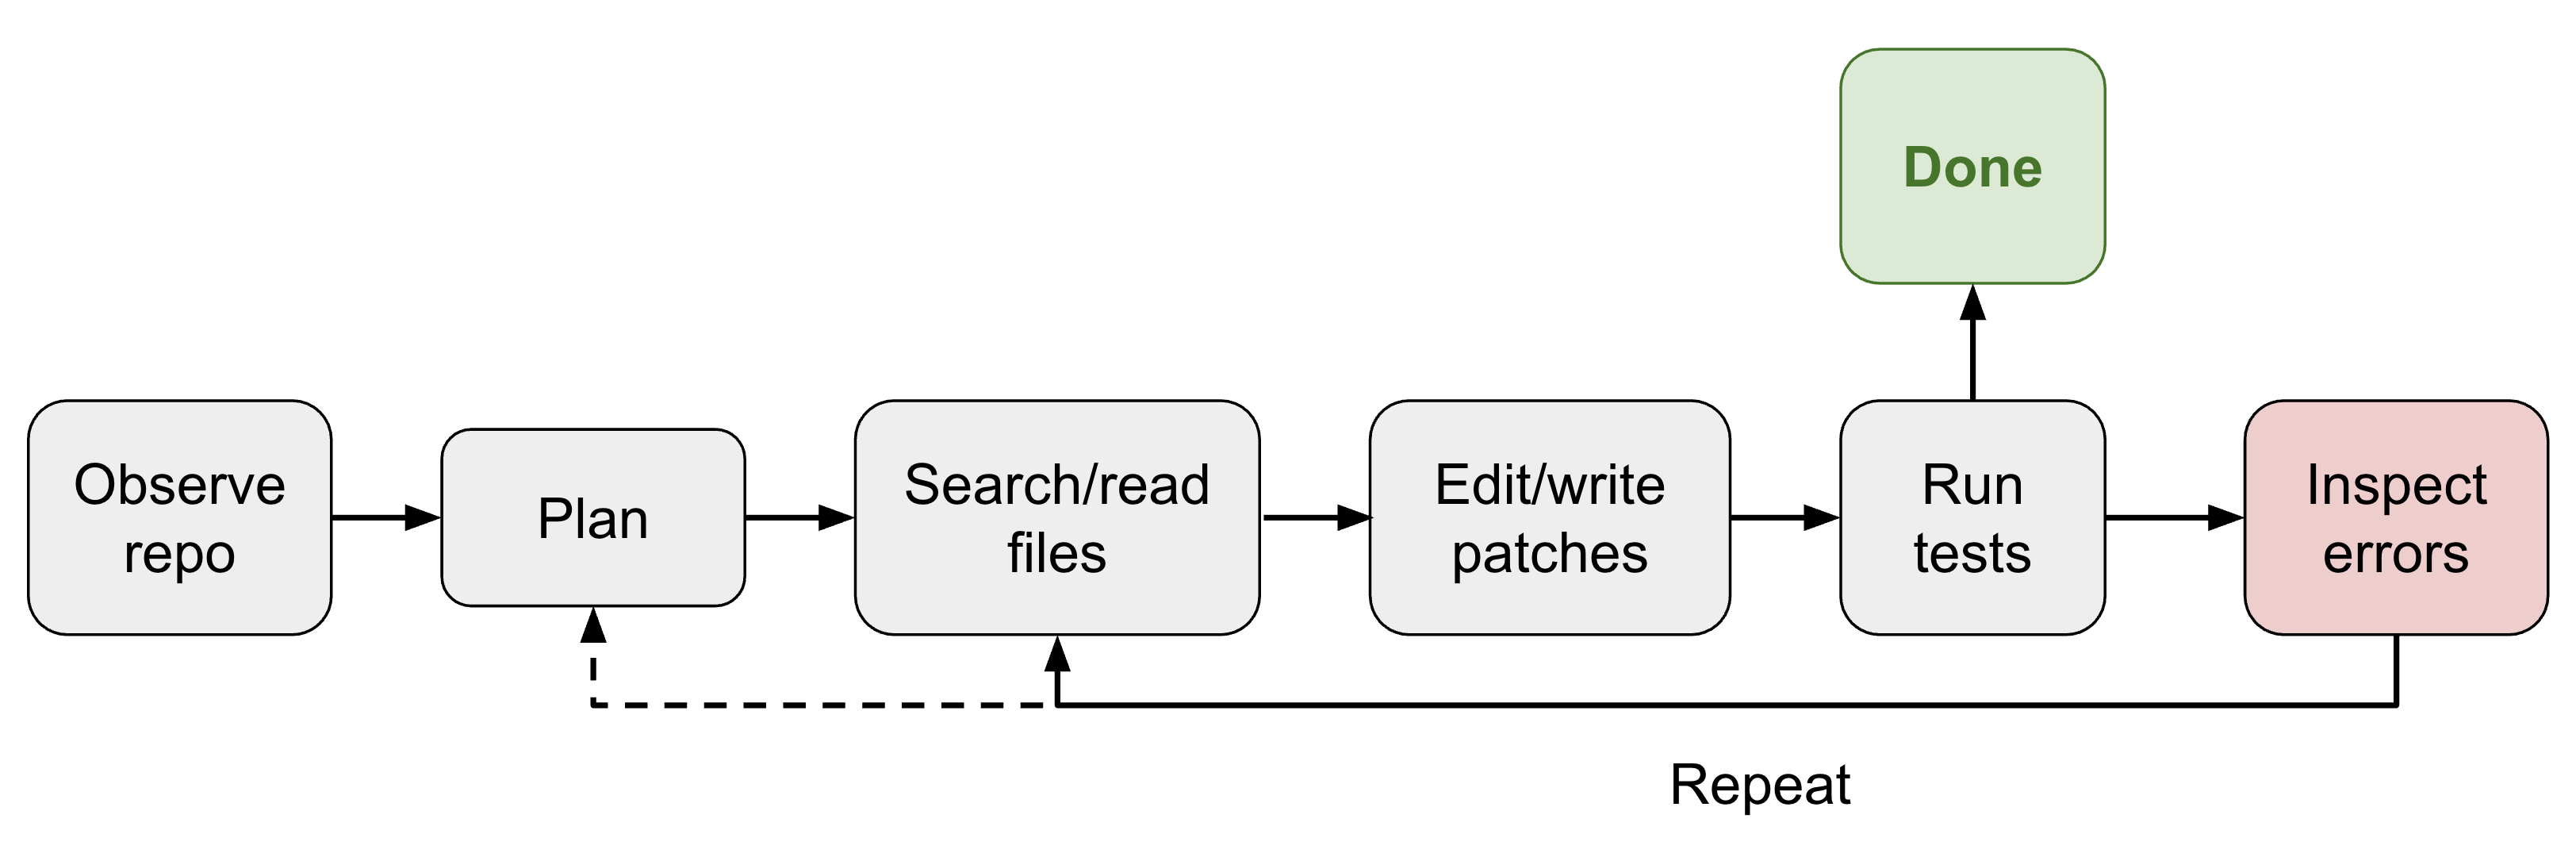
編碼 Agent 的 Harness 迴圈:從使用者意圖到程式碼交付,工具介面編排全過程(來源:Lilian Weng, 2026)
互動體驗:三種架構如何執行
就緒
Plan
Execute
Observe
Improve
↩ 迴圈
第 4 輪就開始丟資訊
所有工具返回、歷史軌跡全塞進上下文,視窗很快打滿。Agent 開始遺忘早期資訊,輸出品質驟降。
三大模式如何協同
三個模式是三層疊加,無需三選一
工作流自動化提供了執行的脊椎:迴圈結構和回饋機制。
檔案系統記憶為迴圈提供了硬碟:讓每輪迭代的成果不會丟失,即使上下文被清空。
子 Agent 並行為迴圈提供了多核:當任務可分解時,用並行加速取代序列等待。
三者組合,一個 Agent 就具備了迭代優化 × 長期記憶 × 並行擴展的能力。這正是當前最強編碼 Agent 的共同架構。
檔案系統記憶為迴圈提供了硬碟:讓每輪迭代的成果不會丟失,即使上下文被清空。
子 Agent 並行為迴圈提供了多核:當任務可分解時,用並行加速取代序列等待。
三者組合,一個 Agent 就具備了迭代優化 × 長期記憶 × 並行擴展的能力。這正是當前最強編碼 Agent 的共同架構。
核心觀點:Harness 設計不是隨機拼湊工具。它遵循三個結構性模式:目標導向的自動化迴圈(讓 Agent 能自我糾錯)、檔案系統做長期記憶(突破上下文視窗限制)、子 Agent 做並行擴展(把序列瓶頸變成多執行緒)。理解這三個模式,就掌握了構建生產級 Agent 系統的架構語言。